Chinese General Practice ›› 2026, Vol. 29 ›› Issue (32): 4700-4709.DOI: 10.12114/j.issn.1007-9572.2026.0032
• Methodology Series in Chinese General Practice Medicine (Ⅲ) • Previous Articles Next Articles
Received:2026-03-05
Revised:2026-05-06
Published:2026-11-15
Online:2026-10-10
Contact:
YANG Lihong
通讯作者:
杨丽虹
作者简介:作者贡献:
韦柏安负责文献调研、资料整合、案例分析、论文撰写与修订;余艳、邱幸莹参与研究内容的讨论,案例分析,协助文献检索与资料整理;郭新峰负责论文审查及修订;杨丽虹提供经费支持及负责研究的总体构思与设计、论文审校与最终定稿。
基金资助:
Add to citation manager EndNote|Ris|BibTeX
URL: https://www.chinagp.net/EN/10.12114/j.issn.1007-9572.2026.0032
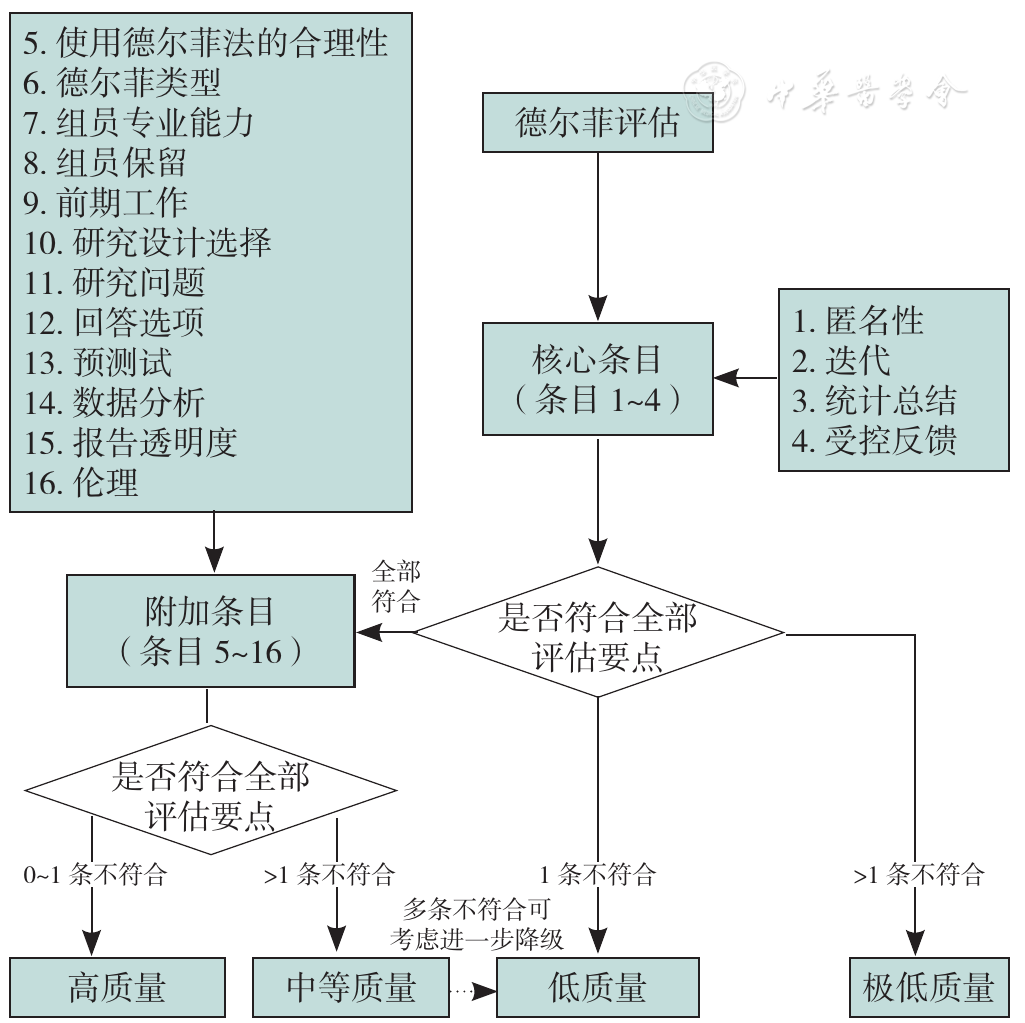
Figure 1 DCAT framework and its evaluation process
| 匿名形式 | 核心特征 | 适用情境 | 潜在风险 | 防控措施 |
|---|---|---|---|---|
| 完全匿名 | 身份完全隐匿,仅通过编码关联数据,反馈仅含统计结果 | 经典德尔菲、跨领域小组成员共识构建、敏感话题研究 | 小组成员责任感不足,回答严谨性可能下降 | 明确研究重要性与应用价值,通过定期提醒强化参与意识,设置答题质量校验机制 |
| 部分匿名(身份可知,意见匿名) | 知晓参与群体构成,但个体观点不可追溯 | 需平衡专业互动与独立判断的改良德尔菲 | 熟人网络导致私下讨论,破坏观点独立性 | 严格签署保密协议,明确禁止线下观点打探,扩大参与群体的机构多样性 |
| 匿名+末轮面对面/在线讨论 | 前几轮完全匿名,末轮聚焦分歧点进行互动澄清 | 需深度解析分歧原因的复杂议题研究 | 讨论中再现权威压力,违背匿名初衷 | 末轮讨论仅针对匿名统计结果中的分歧点,设置中立主持人把控话语权平衡,禁止提及或暗示他人既往观点 |
Table 1 Applicable scenarios and risk mitigation for different anonymity forms
| 匿名形式 | 核心特征 | 适用情境 | 潜在风险 | 防控措施 |
|---|---|---|---|---|
| 完全匿名 | 身份完全隐匿,仅通过编码关联数据,反馈仅含统计结果 | 经典德尔菲、跨领域小组成员共识构建、敏感话题研究 | 小组成员责任感不足,回答严谨性可能下降 | 明确研究重要性与应用价值,通过定期提醒强化参与意识,设置答题质量校验机制 |
| 部分匿名(身份可知,意见匿名) | 知晓参与群体构成,但个体观点不可追溯 | 需平衡专业互动与独立判断的改良德尔菲 | 熟人网络导致私下讨论,破坏观点独立性 | 严格签署保密协议,明确禁止线下观点打探,扩大参与群体的机构多样性 |
| 匿名+末轮面对面/在线讨论 | 前几轮完全匿名,末轮聚焦分歧点进行互动澄清 | 需深度解析分歧原因的复杂议题研究 | 讨论中再现权威压力,违背匿名初衷 | 末轮讨论仅针对匿名统计结果中的分歧点,设置中立主持人把控话语权平衡,禁止提及或暗示他人既往观点 |
| 轮次 | 核心任务 | 方法学要求 | 实施要点 |
|---|---|---|---|
| 第1轮 | 条目生成/初筛 | 开放题与结构化条目结合 | 问题需具体、无歧义,避免引导性表述;对开放反馈进行编码整合,形成标准化评分条目 |
| 第2轮 | 量化评分+群体反馈+意见收敛与确认 | 统一评分工具+受控反馈+个性化反馈+修订机会 | 采用4~7点Likert量表(偶数级可减少中立倾向);反馈包含集中趋势及离散程度,可辅以可视化图表;向小组成员呈现其个人上一轮评分与群体结果的对比;对未达共识的条目保留修订权,对已达共识的条目可提供"最终确认"选项 |
Table 2 Overview of typical iterative designs
| 轮次 | 核心任务 | 方法学要求 | 实施要点 |
|---|---|---|---|
| 第1轮 | 条目生成/初筛 | 开放题与结构化条目结合 | 问题需具体、无歧义,避免引导性表述;对开放反馈进行编码整合,形成标准化评分条目 |
| 第2轮 | 量化评分+群体反馈+意见收敛与确认 | 统一评分工具+受控反馈+个性化反馈+修订机会 | 采用4~7点Likert量表(偶数级可减少中立倾向);反馈包含集中趋势及离散程度,可辅以可视化图表;向小组成员呈现其个人上一轮评分与群体结果的对比;对未达共识的条目保留修订权,对已达共识的条目可提供"最终确认"选项 |
| 反馈设计要素 | 实施方式 | 主要作用 |
|---|---|---|
| 统计反馈 | 呈现中位数/均值、范围/四分位间距及个人得分 | 促进基于信息的修订,降低评分极端性 |
| 质性反馈 | 汇总具有代表性的评论意见 | 协助理解分歧产生的原因 |
| 按群体分层 | 按不同利益相关方展示反馈结果 | 增强不同群体间的共识,影响条目保留决策 |
| 共识阈值确定 | 明确标识高/低共识水平(如≥75%) | 可能引导达成共识,也可能触发逆反心理 |
Table 3 Common design methods and functions of controlled feedback
| 反馈设计要素 | 实施方式 | 主要作用 |
|---|---|---|
| 统计反馈 | 呈现中位数/均值、范围/四分位间距及个人得分 | 促进基于信息的修订,降低评分极端性 |
| 质性反馈 | 汇总具有代表性的评论意见 | 协助理解分歧产生的原因 |
| 按群体分层 | 按不同利益相关方展示反馈结果 | 增强不同群体间的共识,影响条目保留决策 |
| 共识阈值确定 | 明确标识高/低共识水平(如≥75%) | 可能引导达成共识,也可能触发逆反心理 |
| 应用方向 | 主要目的 | 注意事项 |
|---|---|---|
| 指标体系、量表或指南的构建 | 形成基于小组成员共识的推荐条目或操作规范 | 共识结果属于小组成员意见,不等同于因果性证据,需通过实证研究进一步验证 |
| 政策分析、情景预测与前瞻研究 | 预测未来趋势,识别潜在选项并厘清关键分歧 | 研究结果高度依赖于预设的情景框架及所选小组成员的构成与代表性 |
| 复杂问题的结构化剖析 | 系统梳理关键影响因素并确定其相对优先级 | 结论易受小组成员样本偏差、问卷设计及反馈流程的影响 |
Table 4 Typical application scenarios of the Delphi method
| 应用方向 | 主要目的 | 注意事项 |
|---|---|---|
| 指标体系、量表或指南的构建 | 形成基于小组成员共识的推荐条目或操作规范 | 共识结果属于小组成员意见,不等同于因果性证据,需通过实证研究进一步验证 |
| 政策分析、情景预测与前瞻研究 | 预测未来趋势,识别潜在选项并厘清关键分歧 | 研究结果高度依赖于预设的情景框架及所选小组成员的构成与代表性 |
| 复杂问题的结构化剖析 | 系统梳理关键影响因素并确定其相对优先级 | 结论易受小组成员样本偏差、问卷设计及反馈流程的影响 |
| 类型 | 核心目标与特点 | 小组组成 | 实施流程 | 关键特征 |
|---|---|---|---|---|
| 经典德尔菲法(Classical Delphi) | 旨在通过多轮、匿名的意见收集与反馈,促进小组成员达成共识,减少观点离散度 | 通常为领域专家,规模依研究需求而定 | 1.首轮多采用开放式问题,征集议题;2.后续轮次使用封闭式问题,小组成员独立评价并说明理由;3.组织者汇总并反馈匿名化群体结果(含个人应答、整体分布及理由);4.小组成员参考反馈修订观点,流程重复≥1次;5.整合最终评价判断共识达成情况 | 强调匿名性、多轮迭代与群体反馈;适用于意见收敛与共识形成 |
| 政策德尔菲法(Policy Delphi) | 旨在系统识别政策议题的多元观点与分歧,探索能为不同利益相关者接受的潜在政策方案,并评估其影响、可接受性与后果 | 刻意纳入背景多元、观点异质甚至对立利益相关者(含极端观点),规模通常较大 | 1.首轮通过开放式问题收集政策选项及相关后果意见;2.研究团队提炼政策选项,设计结构化问卷;3.小组成员对选项的重要性、合意性、可行性及自身信心评分;4.下一轮小组成员可参考前轮结果修订应答,并可建议修改选项表述或提出新选项 | 注重分歧识别与政策选项的全面评估;适用于政策分析与战略规划 |
| 改良德尔菲法(Modified Delphi) | 常特指RAM,旨在结合证据与小组成员判断,评估临床指征或干预的适宜性。核心改进包括引入面对面讨论、限定轮次与小组规模、使用标准化评分量表及提供前期证据综述 | 通常为9~18名具备多元临床背景的多学科小组成员(如专科与全科医师) | 1.研究团队提供证据综述并制定待评估临床场景;2.小组成员使用9点Likert评分量表独立评价适宜性;3.反馈个体化报告(含群体分布、个人评分及共识状态);4.举行1~2 d面对面讨论(由有经验主持人引导),重点讨论未共识条目;5.讨论后可重新评分,部分研究增加必要性评价环节 | 融合匿名评分与结构化面对面讨论;制定明确的共识判定标准(基于离散度与中位数);广泛应用于医疗适宜性评估 |
| 在线德尔菲法(e-Delphi) | 利用在线平台实施,提升调研效率、便于数据管理与分析,通常保留多轮结构但周期缩短 | 规模灵活,依托网络平台招募与管理小组成员 | 1.可进行预征集轮征集兴趣与开放式意见;2.研究团队整合意见后设计封闭式问卷;3.多轮在线调研(通常3~4轮),中间轮次提供个性化反馈报告;4.部分平台(如ExpertLens)设置非同步、有主持的在线讨论区供小组成员交流;5.利用平台分析工具实时监测参与度、分析共识/分歧原因 | 在线化、流程自动化;支持非同步讨论与人工智能辅助分析;显著缩短研究周期 |
| 实时德尔菲法(Real-time Delphi) | 取消固定轮次,实现持续、动态的意见收集与反馈,小组成员可随时修订答案并实时查看更新的群体响应 | 规模与组成灵活,依赖实时交互软件 | 1.小组成员随时登录系统回答问题;2.系统实时计算并展示群体反馈;3.小组成员可立即查看自身应答与群体分布的差异,并随时调整;4.群体统计结果随新应答持续更新,无明确轮次截止 | "无轮次"连续动态过程;反馈实时更新;赋予小组成员更大参与自由,进一步缩短数据收集周期 |
Table 5 Common types of Delphi studies
| 类型 | 核心目标与特点 | 小组组成 | 实施流程 | 关键特征 |
|---|---|---|---|---|
| 经典德尔菲法(Classical Delphi) | 旨在通过多轮、匿名的意见收集与反馈,促进小组成员达成共识,减少观点离散度 | 通常为领域专家,规模依研究需求而定 | 1.首轮多采用开放式问题,征集议题;2.后续轮次使用封闭式问题,小组成员独立评价并说明理由;3.组织者汇总并反馈匿名化群体结果(含个人应答、整体分布及理由);4.小组成员参考反馈修订观点,流程重复≥1次;5.整合最终评价判断共识达成情况 | 强调匿名性、多轮迭代与群体反馈;适用于意见收敛与共识形成 |
| 政策德尔菲法(Policy Delphi) | 旨在系统识别政策议题的多元观点与分歧,探索能为不同利益相关者接受的潜在政策方案,并评估其影响、可接受性与后果 | 刻意纳入背景多元、观点异质甚至对立利益相关者(含极端观点),规模通常较大 | 1.首轮通过开放式问题收集政策选项及相关后果意见;2.研究团队提炼政策选项,设计结构化问卷;3.小组成员对选项的重要性、合意性、可行性及自身信心评分;4.下一轮小组成员可参考前轮结果修订应答,并可建议修改选项表述或提出新选项 | 注重分歧识别与政策选项的全面评估;适用于政策分析与战略规划 |
| 改良德尔菲法(Modified Delphi) | 常特指RAM,旨在结合证据与小组成员判断,评估临床指征或干预的适宜性。核心改进包括引入面对面讨论、限定轮次与小组规模、使用标准化评分量表及提供前期证据综述 | 通常为9~18名具备多元临床背景的多学科小组成员(如专科与全科医师) | 1.研究团队提供证据综述并制定待评估临床场景;2.小组成员使用9点Likert评分量表独立评价适宜性;3.反馈个体化报告(含群体分布、个人评分及共识状态);4.举行1~2 d面对面讨论(由有经验主持人引导),重点讨论未共识条目;5.讨论后可重新评分,部分研究增加必要性评价环节 | 融合匿名评分与结构化面对面讨论;制定明确的共识判定标准(基于离散度与中位数);广泛应用于医疗适宜性评估 |
| 在线德尔菲法(e-Delphi) | 利用在线平台实施,提升调研效率、便于数据管理与分析,通常保留多轮结构但周期缩短 | 规模灵活,依托网络平台招募与管理小组成员 | 1.可进行预征集轮征集兴趣与开放式意见;2.研究团队整合意见后设计封闭式问卷;3.多轮在线调研(通常3~4轮),中间轮次提供个性化反馈报告;4.部分平台(如ExpertLens)设置非同步、有主持的在线讨论区供小组成员交流;5.利用平台分析工具实时监测参与度、分析共识/分歧原因 | 在线化、流程自动化;支持非同步讨论与人工智能辅助分析;显著缩短研究周期 |
| 实时德尔菲法(Real-time Delphi) | 取消固定轮次,实现持续、动态的意见收集与反馈,小组成员可随时修订答案并实时查看更新的群体响应 | 规模与组成灵活,依赖实时交互软件 | 1.小组成员随时登录系统回答问题;2.系统实时计算并展示群体反馈;3.小组成员可立即查看自身应答与群体分布的差异,并随时调整;4.群体统计结果随新应答持续更新,无明确轮次截止 | "无轮次"连续动态过程;反馈实时更新;赋予小组成员更大参与自由,进一步缩短数据收集周期 |
| 遴选原则 | 核心要求 | 具体说明与评判依据 |
|---|---|---|
| 专业性 | 小组成员通常须具备与研究主题高度相关的专业知识与实践经验,此为最核心的遴选原则 | 评判标准通常包括:相关领域的工作年限、学术成果、项目参与经验、行业影响力等 |
| 适配性 | 小组成员的专长领域应与研究议题直接匹配,而非仅依据头衔或社会地位进行选择 | 需根据研究的具体目标(如临床实践、科研导向、政策制定)匹配相应类型小组成员 |
| 代表性 | 小组应在学科背景、职业角色、地域分布、性别等方面保持适度多样性 | 多元构成有助于减少系统性偏倚、汇集不同视角,从而提高研究结论的广泛适用性与可信度 |
| 公正性 | 遴选标准、流程须事先确定并在研究报告中公开,确保过程可追溯、可复查 | 应公开说明小组成员的纳入与排除标准、招募方式、最终小组的构成情况等信息 |
| 匹配性 | 小组成员人数应与研究议题的广度、复杂度相匹配 | 核心在于"适宜"而非"越多越好"。对于涉及领域广泛或争议较大的议题,可酌情适当增加小组成员数量 |
Table 6 Selection principles for Delphi panel members
| 遴选原则 | 核心要求 | 具体说明与评判依据 |
|---|---|---|
| 专业性 | 小组成员通常须具备与研究主题高度相关的专业知识与实践经验,此为最核心的遴选原则 | 评判标准通常包括:相关领域的工作年限、学术成果、项目参与经验、行业影响力等 |
| 适配性 | 小组成员的专长领域应与研究议题直接匹配,而非仅依据头衔或社会地位进行选择 | 需根据研究的具体目标(如临床实践、科研导向、政策制定)匹配相应类型小组成员 |
| 代表性 | 小组应在学科背景、职业角色、地域分布、性别等方面保持适度多样性 | 多元构成有助于减少系统性偏倚、汇集不同视角,从而提高研究结论的广泛适用性与可信度 |
| 公正性 | 遴选标准、流程须事先确定并在研究报告中公开,确保过程可追溯、可复查 | 应公开说明小组成员的纳入与排除标准、招募方式、最终小组的构成情况等信息 |
| 匹配性 | 小组成员人数应与研究议题的广度、复杂度相匹配 | 核心在于"适宜"而非"越多越好"。对于涉及领域广泛或争议较大的议题,可酌情适当增加小组成员数量 |
| 策略 | 具体实施方法 | 主要目的 |
|---|---|---|
| 个性化邀请 | 发送具名邀请函与提醒邮件,适时提供个人化感谢与反馈 | 增强小组成员的归属感与责任感,提升其持续参与的意愿 |
| 问卷结构优化 | 使用清晰易懂的表述、合理设置题目分组、采用通用量表,必要时与小组成员共同修订表述 | 降低答题的认知负荷,减少因表述模糊或结构混乱导致的参与障碍 |
| 实时统计反馈 | 每轮结束后及时提供集中趋势与离散程度的统计结果,并辅以可视化图表 | 使小组成员直观了解个人意见与群体分布的关系,感知自身贡献,促进意见收敛与持续投入 |
| 控制轮次间隔 | 借助在线调研平台或专用软件,快速完成数据统计并开启下一轮调查 | 减少小组成员因流程拖延而产生的遗忘或流失,保持研究节奏与参与热度 |
Table 7 Common strategies for panel member retention
| 策略 | 具体实施方法 | 主要目的 |
|---|---|---|
| 个性化邀请 | 发送具名邀请函与提醒邮件,适时提供个人化感谢与反馈 | 增强小组成员的归属感与责任感,提升其持续参与的意愿 |
| 问卷结构优化 | 使用清晰易懂的表述、合理设置题目分组、采用通用量表,必要时与小组成员共同修订表述 | 降低答题的认知负荷,减少因表述模糊或结构混乱导致的参与障碍 |
| 实时统计反馈 | 每轮结束后及时提供集中趋势与离散程度的统计结果,并辅以可视化图表 | 使小组成员直观了解个人意见与群体分布的关系,感知自身贡献,促进意见收敛与持续投入 |
| 控制轮次间隔 | 借助在线调研平台或专用软件,快速完成数据统计并开启下一轮调查 | 减少小组成员因流程拖延而产生的遗忘或流失,保持研究节奏与参与热度 |
| 类别 | 优化建议 | 目的 |
|---|---|---|
| 题量过多、作答时间过长 | 适当减少需评分项目的数量 | 降低作答疲劳,保障小组成员连续参与调研 |
| 语言表述晦涩难懂 | 调整专业术语、修正歧义表述 | 实现与指南术语的统一,同时保证表述通俗易懂 |
| 量表结构混乱 | 检验量表维度合理性、核查反向题设置 | 确保量表的信效度,提升结果的可解释性 |
Table 8 Common issues in pilot testing and optimization suggestions
| 类别 | 优化建议 | 目的 |
|---|---|---|
| 题量过多、作答时间过长 | 适当减少需评分项目的数量 | 降低作答疲劳,保障小组成员连续参与调研 |
| 语言表述晦涩难懂 | 调整专业术语、修正歧义表述 | 实现与指南术语的统一,同时保证表述通俗易懂 |
| 量表结构混乱 | 检验量表维度合理性、核查反向题设置 | 确保量表的信效度,提升结果的可解释性 |
| 条目 | 具体问题 | 评价结果 | 评价理由 |
|---|---|---|---|
| 核心条目 | |||
| 条目1 | 德尔菲研究中是否恰当采用匿名性? | 是☑ 否□ 不确定□ | 研究使用了在线平台进行改良德尔菲调查,该平台作为德尔菲调查的核心工具之一,可以保证参与者的匿名性。并且原文直接提及使用匿名、在线讨论的方法对德尔菲第一轮调查结果进行讨论 |
| 条目2 | 德尔菲研究中是否恰当采用迭代法? | 是☑ 否□ 不确定□ | 研究中使用了3轮德尔菲调查 |
| 条目3 | 德尔菲研究中是否恰当采用群体应答的统计总结? | 是☑ 否□ 不确定□ | 研究者使用直方图展示/比较上一轮调查结果,并使用主题分析对开放性文本内容进行分析;统计分析部分详细描述了统计分析计划以及达成共识的标准;结果部分展示了定性和定量分析的结果 |
| 条目4 | 德尔菲研究中是否恰当采用受控反馈? | 是☑ 否□ 不确定□ | 研究者在第2轮德尔菲中向专家定量描述每位专家第1轮的回答与其他专家回答的比较,定性分析开放性问题的回答;在第1轮和第3轮之间进行在线小组讨论和反馈 |
| 附加条目 | |||
| 条目5 | 研究团队是否为该研究中德尔菲法的使用提供了适当的理由? | 是☑ 否□ 不确定□ | 引言第2段和第3段写明了选择德尔菲方法的原因,且原因符合使用德尔菲的条件 |
| 条目6 | 研究团队是否为该研究中所采用的德尔菲法类型提供了适当的理由? | 是☑ 否□ 不确定□ | 引言第2段和第3段说明了选择在线改良德尔菲法的原因 |
| 条目7 | 研究团队是否为德尔菲研究寻求了恰当的专业意见? | 是☑ 否□ 不确定□ | 文章中参与者部分说明了参与者的招募方式,参与者涵盖了主题相关利益方,并说明了参与者选择标准 |
| 条目8 | 研究团队在整个德尔菲研究过程中是否充分保留了小组成员? | 是☑ 否□ 不确定□ | 拟定样本量20~40符合德尔菲研究的要求;结果显示66名参与者完成至少1轮德尔菲调查,第3轮完成率分别为效果评估组83%和实施评估组75% |
| 条目9 | 研究团队在德尔菲研究第一轮之前是否开展了前期工作? | 是☑ 否□ 不确定□ | 在首轮前通过文献回顾、咨询项目顾问委员会筛选出14项核心政策,明确了每项政策的定义与背景信息,为专家评分提供了充分依据 |
| 条目10 | 研究团队是否为德尔菲研究做出了恰当的设计选择? | 是☑ 否□ 不确定□ | 采用线上3轮改良德尔菲设计,预设固定轮次同时允许基于共识进展灵活调整,讨论环节采用非同步匿名模式以避免群体思维,设计要素与"评估政策有效性与可实施性"的目标高度适配 |
| 条目11 | 研究团队在德尔菲研究中是否提出了恰当的问题? | 是☑ 否□ 不确定□ | 针对14项政策,分别围绕"对治疗参与度的影响"等有效性指标,以及"可行性""可负担性"等实施性指标设计问题并对每个问题给出清晰定义 |
| 条目12 | 研究团队在德尔菲研究中是否使用了恰当的应答条目? | 是☑ 否□ 不确定□ | 该研究使用了Likert 9点量表,并且设置了开放性问题框 |
| 条目13 | 研究团队在开展德尔菲研究之前是否进行了预测试? | 是☑ 否□ 不确定□ | 在研究正式开始前,进行了预测试 |
| 条目14 | 研究团队是否对德尔菲研究的数据进行了恰当分析? | 是☑ 否□ 不确定□ | 采用RAM中的百分位距调整对称分析技术判定共识,结合主题分析法处理专家评论,预先在OSF平台注册了分析方案,并明确了缺失数据处理方式 |
| 条目15 | 研究团队是否对其德尔菲研究进行了透明化报告? | 是☑ 否□ 不确定□ | 结果详细报告相关数据,并且注册的方案、研究计划和材料有附上相应的网址;报告遵循定性研究报告标准(SRQR) |
| 条目16 | 研究团队是否恰当考虑了伦理问题? | 是☑ 否□ 不确定□ | 研究获得了伦理豁免 |
| 核心条目(条目1~4) | 是: 4 否: 不确定: | ||
| 附加条目(条目5~16) | 是: 12 否: 不确定: | ||
| 整体质量评价 | 高☑中等□低□极低□ | ||
| 评估说明 | 该德尔菲研究在设计、实施、分析和报告方面均属高质量,其研究结果可为阿片类药物使用障碍治疗相关的政策制定提供有力的专家共识依据 | ||
Table 9 Case 1 of Delphi study quality assessment:expert panel consensus on state-level policies to improve engagement and retention in treatment for opioid use disorder
| 条目 | 具体问题 | 评价结果 | 评价理由 |
|---|---|---|---|
| 核心条目 | |||
| 条目1 | 德尔菲研究中是否恰当采用匿名性? | 是☑ 否□ 不确定□ | 研究使用了在线平台进行改良德尔菲调查,该平台作为德尔菲调查的核心工具之一,可以保证参与者的匿名性。并且原文直接提及使用匿名、在线讨论的方法对德尔菲第一轮调查结果进行讨论 |
| 条目2 | 德尔菲研究中是否恰当采用迭代法? | 是☑ 否□ 不确定□ | 研究中使用了3轮德尔菲调查 |
| 条目3 | 德尔菲研究中是否恰当采用群体应答的统计总结? | 是☑ 否□ 不确定□ | 研究者使用直方图展示/比较上一轮调查结果,并使用主题分析对开放性文本内容进行分析;统计分析部分详细描述了统计分析计划以及达成共识的标准;结果部分展示了定性和定量分析的结果 |
| 条目4 | 德尔菲研究中是否恰当采用受控反馈? | 是☑ 否□ 不确定□ | 研究者在第2轮德尔菲中向专家定量描述每位专家第1轮的回答与其他专家回答的比较,定性分析开放性问题的回答;在第1轮和第3轮之间进行在线小组讨论和反馈 |
| 附加条目 | |||
| 条目5 | 研究团队是否为该研究中德尔菲法的使用提供了适当的理由? | 是☑ 否□ 不确定□ | 引言第2段和第3段写明了选择德尔菲方法的原因,且原因符合使用德尔菲的条件 |
| 条目6 | 研究团队是否为该研究中所采用的德尔菲法类型提供了适当的理由? | 是☑ 否□ 不确定□ | 引言第2段和第3段说明了选择在线改良德尔菲法的原因 |
| 条目7 | 研究团队是否为德尔菲研究寻求了恰当的专业意见? | 是☑ 否□ 不确定□ | 文章中参与者部分说明了参与者的招募方式,参与者涵盖了主题相关利益方,并说明了参与者选择标准 |
| 条目8 | 研究团队在整个德尔菲研究过程中是否充分保留了小组成员? | 是☑ 否□ 不确定□ | 拟定样本量20~40符合德尔菲研究的要求;结果显示66名参与者完成至少1轮德尔菲调查,第3轮完成率分别为效果评估组83%和实施评估组75% |
| 条目9 | 研究团队在德尔菲研究第一轮之前是否开展了前期工作? | 是☑ 否□ 不确定□ | 在首轮前通过文献回顾、咨询项目顾问委员会筛选出14项核心政策,明确了每项政策的定义与背景信息,为专家评分提供了充分依据 |
| 条目10 | 研究团队是否为德尔菲研究做出了恰当的设计选择? | 是☑ 否□ 不确定□ | 采用线上3轮改良德尔菲设计,预设固定轮次同时允许基于共识进展灵活调整,讨论环节采用非同步匿名模式以避免群体思维,设计要素与"评估政策有效性与可实施性"的目标高度适配 |
| 条目11 | 研究团队在德尔菲研究中是否提出了恰当的问题? | 是☑ 否□ 不确定□ | 针对14项政策,分别围绕"对治疗参与度的影响"等有效性指标,以及"可行性""可负担性"等实施性指标设计问题并对每个问题给出清晰定义 |
| 条目12 | 研究团队在德尔菲研究中是否使用了恰当的应答条目? | 是☑ 否□ 不确定□ | 该研究使用了Likert 9点量表,并且设置了开放性问题框 |
| 条目13 | 研究团队在开展德尔菲研究之前是否进行了预测试? | 是☑ 否□ 不确定□ | 在研究正式开始前,进行了预测试 |
| 条目14 | 研究团队是否对德尔菲研究的数据进行了恰当分析? | 是☑ 否□ 不确定□ | 采用RAM中的百分位距调整对称分析技术判定共识,结合主题分析法处理专家评论,预先在OSF平台注册了分析方案,并明确了缺失数据处理方式 |
| 条目15 | 研究团队是否对其德尔菲研究进行了透明化报告? | 是☑ 否□ 不确定□ | 结果详细报告相关数据,并且注册的方案、研究计划和材料有附上相应的网址;报告遵循定性研究报告标准(SRQR) |
| 条目16 | 研究团队是否恰当考虑了伦理问题? | 是☑ 否□ 不确定□ | 研究获得了伦理豁免 |
| 核心条目(条目1~4) | 是: 4 否: 不确定: | ||
| 附加条目(条目5~16) | 是: 12 否: 不确定: | ||
| 整体质量评价 | 高☑中等□低□极低□ | ||
| 评估说明 | 该德尔菲研究在设计、实施、分析和报告方面均属高质量,其研究结果可为阿片类药物使用障碍治疗相关的政策制定提供有力的专家共识依据 | ||
| 条目 | 具体问题 | 评价结果 | 依据 |
|---|---|---|---|
| 核心条目 | |||
| 条目1 | 德尔菲研究中是否恰当采用匿名性? | 是☑ 否 □不确定□ | 原文未明确说明匿名性的实施细节。根据其"问卷星或面呈"的发放方式来看,该研究较好地兼顾了匿名性的要求 |
| 条目2 | 德尔菲研究中是否恰当采用迭代法? | 是☑ 否□ 不确定□ | 原文开展了两轮专家咨询,第1轮收集意见后汇总分析,第2轮将首轮结果反馈给专家,专家基于前期结果再次填写意见,且两轮均采用统一的Likert 5分量表评分标准 |
| 条目3 | 德尔菲研究中是否恰当采用群体应答的统计总结? | 是☑ 否□ 不确定□ | 原文采用SPSS 26.0软件,计算了均数、变异系数、肯德尔和谐系数、权威系数等多项统计指标,用于分析专家意见的共识程度、协调程度及可靠性,以统计结果作为条目筛选和共识判定的核心依据 |
| 条目4 | 德尔菲研究中是否恰当采用受控反馈? | 是□ 否□ 不确定☑ | "第二轮,将第一轮汇总分析结果反馈给专家,专家在参考前期结果的基础上,再次填写并提交自己的意见。"原文提及将第一轮结果反馈给专家,但未描述反馈呈现形式,以及是否列出成员自身回复与他人比较。 |
| 附加条目 | |||
| 条目5 | 研究团队是否为该研究中德尔菲法的使用提供了适当的理由? | 是☑ 否□ 不确定□ | 现有高血压病痰瘀互结证诊断依赖医生主观判断和传统辨证方法,精确性和客观性不足,而德尔菲法可广泛整合专家意见,挖掘宏观与微观结合的诊断条目,适配"证据不充分、需多专家共识"的研究场景,故判定为"是" |
| 条目6 | 研究团队是否为该研究中所采用的德尔菲法类型提供了适当的理由? | 是□ 否□ 不确定☑ | 未明确说明采用的是德尔菲类型。原文中两轮问卷+统计总结更接近经典德尔菲或改良德尔菲 |
| 条目7 | 研究团队是否为德尔菲研究寻求了恰当的专业意见? | 是□ 否□ 不确定☑ | 仅大致说明"基于广泛性、权威性与代表性原则,邀请30位在高血压病相关领域具有丰富研究经验的专家参与研究",未明确列出专家的纳入标准和招募方式 |
| 条目8 | 研究团队在整个德尔菲研究过程中是否充分保留了小组成员? | 是☑ 否□ 不确定□ | 两轮问卷均发放30份,回收26份,回收率为86.67%(≥80%),专家留存率稳定;最终26名专家完成两轮咨询,样本量满足共识分析需求,原文虽未提及留存策略,但留存效果达标,故判定为"是" |
| 条目9 | 研究团队在德尔菲研究第一轮咨询之前是否开展了前期工作? | 是☑ 否□ 不确定□ | 工作组系统检索8个中英文数据库,梳理高血压病"痰瘀"证素相关文献,提取临床常见四诊条目与生化指标,拆分复合舌脉象,经课题组专家讨论形成56个条目池,为首轮问卷提供了充分的证据基础 |
| 条目10 | 研究团队是否为德尔菲研究选择了恰当的设计? | 是☑ 否□ 不确定□ | 采用"两轮咨询+条目筛选+主次症划分"设计,预设条目筛选标准和主次症划分标准,通过问卷星或面呈发放问卷 |
| 条目11 | 研究团队在德尔菲研究中是否提出了恰当的问题? | 是☑ 否□ 不确定□ | 问卷条目源于文献梳理和专家讨论,聚焦高血压病痰瘀互结证的诊断相关指标,将复合舌脉象拆分为单一条目,表述具体、无歧义、无偏倚,统一围绕"条目重要性"设计问题 |
| 条目12 | 研究团队在德尔菲研究中是否使用了恰当的应答条目? | 是☑ 否□ 不确定□ | 采用Likert 5点量表(1分=非常不重要,5分=非常重要),应答选项定义清晰 |
| 条目13 | 研究团队在开展德尔菲研究之前是否进行了预测试? | 是□ 否□ 不确定☑ | 原文未提及在正式发放问卷前是否进行预测试 |
| 条目14 | 研究团队是否对德尔菲研究的数据进行了恰当分析? | 是☑ 否□ 不确定□ | 采用双人双机录入建立数据库,运用SPSS 26.0软件进行描述性统计、协调性分析、信度分析、效度分析,分析方法全面且符合德尔菲研究规范 |
| 条目15 | 研究团队是否对其德尔菲研究进行了透明化报告? | 是□ 否□ 不确定☑ | 未报告专家选择标准、招募方式、反馈机制、资金来源、利益冲突声明等内容 |
| 条目16 | 研究团队是否恰当考虑了伦理问题? | 是□ 否□ 不确定☑ | 原文未提及伦理审查、知情同意、利益冲突披露等内容 |
| 核心条目(条目1~4) | 是: 3 否: 不确定: 1 | ||
| 附加条目(条目5~16) | 是: 7 否: 不确定: 5 | ||
| 整体质量评价 | 高□中等□低☑极低□ | ||
| 评估说明 | 本研究在核心条目与附加条目中大多符合质量标准。受控反馈(条目4)因原文未明确说明而暂评"不确定",后续可通过与作者核实具体反馈情况,进一步确认反馈机制是否合适。总体来看,有5个条目因信息缺失被评为"不确定",其中受控反馈暂不确定。因此,综合判定本研究整体质量为"低"。 | ||
Table 10 Case 2 of Delphi study quality assessment:expert consensus on diagnostic items for phlegm-stasis intermingling syndrome in hypertension
| 条目 | 具体问题 | 评价结果 | 依据 |
|---|---|---|---|
| 核心条目 | |||
| 条目1 | 德尔菲研究中是否恰当采用匿名性? | 是☑ 否 □不确定□ | 原文未明确说明匿名性的实施细节。根据其"问卷星或面呈"的发放方式来看,该研究较好地兼顾了匿名性的要求 |
| 条目2 | 德尔菲研究中是否恰当采用迭代法? | 是☑ 否□ 不确定□ | 原文开展了两轮专家咨询,第1轮收集意见后汇总分析,第2轮将首轮结果反馈给专家,专家基于前期结果再次填写意见,且两轮均采用统一的Likert 5分量表评分标准 |
| 条目3 | 德尔菲研究中是否恰当采用群体应答的统计总结? | 是☑ 否□ 不确定□ | 原文采用SPSS 26.0软件,计算了均数、变异系数、肯德尔和谐系数、权威系数等多项统计指标,用于分析专家意见的共识程度、协调程度及可靠性,以统计结果作为条目筛选和共识判定的核心依据 |
| 条目4 | 德尔菲研究中是否恰当采用受控反馈? | 是□ 否□ 不确定☑ | "第二轮,将第一轮汇总分析结果反馈给专家,专家在参考前期结果的基础上,再次填写并提交自己的意见。"原文提及将第一轮结果反馈给专家,但未描述反馈呈现形式,以及是否列出成员自身回复与他人比较。 |
| 附加条目 | |||
| 条目5 | 研究团队是否为该研究中德尔菲法的使用提供了适当的理由? | 是☑ 否□ 不确定□ | 现有高血压病痰瘀互结证诊断依赖医生主观判断和传统辨证方法,精确性和客观性不足,而德尔菲法可广泛整合专家意见,挖掘宏观与微观结合的诊断条目,适配"证据不充分、需多专家共识"的研究场景,故判定为"是" |
| 条目6 | 研究团队是否为该研究中所采用的德尔菲法类型提供了适当的理由? | 是□ 否□ 不确定☑ | 未明确说明采用的是德尔菲类型。原文中两轮问卷+统计总结更接近经典德尔菲或改良德尔菲 |
| 条目7 | 研究团队是否为德尔菲研究寻求了恰当的专业意见? | 是□ 否□ 不确定☑ | 仅大致说明"基于广泛性、权威性与代表性原则,邀请30位在高血压病相关领域具有丰富研究经验的专家参与研究",未明确列出专家的纳入标准和招募方式 |
| 条目8 | 研究团队在整个德尔菲研究过程中是否充分保留了小组成员? | 是☑ 否□ 不确定□ | 两轮问卷均发放30份,回收26份,回收率为86.67%(≥80%),专家留存率稳定;最终26名专家完成两轮咨询,样本量满足共识分析需求,原文虽未提及留存策略,但留存效果达标,故判定为"是" |
| 条目9 | 研究团队在德尔菲研究第一轮咨询之前是否开展了前期工作? | 是☑ 否□ 不确定□ | 工作组系统检索8个中英文数据库,梳理高血压病"痰瘀"证素相关文献,提取临床常见四诊条目与生化指标,拆分复合舌脉象,经课题组专家讨论形成56个条目池,为首轮问卷提供了充分的证据基础 |
| 条目10 | 研究团队是否为德尔菲研究选择了恰当的设计? | 是☑ 否□ 不确定□ | 采用"两轮咨询+条目筛选+主次症划分"设计,预设条目筛选标准和主次症划分标准,通过问卷星或面呈发放问卷 |
| 条目11 | 研究团队在德尔菲研究中是否提出了恰当的问题? | 是☑ 否□ 不确定□ | 问卷条目源于文献梳理和专家讨论,聚焦高血压病痰瘀互结证的诊断相关指标,将复合舌脉象拆分为单一条目,表述具体、无歧义、无偏倚,统一围绕"条目重要性"设计问题 |
| 条目12 | 研究团队在德尔菲研究中是否使用了恰当的应答条目? | 是☑ 否□ 不确定□ | 采用Likert 5点量表(1分=非常不重要,5分=非常重要),应答选项定义清晰 |
| 条目13 | 研究团队在开展德尔菲研究之前是否进行了预测试? | 是□ 否□ 不确定☑ | 原文未提及在正式发放问卷前是否进行预测试 |
| 条目14 | 研究团队是否对德尔菲研究的数据进行了恰当分析? | 是☑ 否□ 不确定□ | 采用双人双机录入建立数据库,运用SPSS 26.0软件进行描述性统计、协调性分析、信度分析、效度分析,分析方法全面且符合德尔菲研究规范 |
| 条目15 | 研究团队是否对其德尔菲研究进行了透明化报告? | 是□ 否□ 不确定☑ | 未报告专家选择标准、招募方式、反馈机制、资金来源、利益冲突声明等内容 |
| 条目16 | 研究团队是否恰当考虑了伦理问题? | 是□ 否□ 不确定☑ | 原文未提及伦理审查、知情同意、利益冲突披露等内容 |
| 核心条目(条目1~4) | 是: 3 否: 不确定: 1 | ||
| 附加条目(条目5~16) | 是: 7 否: 不确定: 5 | ||
| 整体质量评价 | 高□中等□低☑极低□ | ||
| 评估说明 | 本研究在核心条目与附加条目中大多符合质量标准。受控反馈(条目4)因原文未明确说明而暂评"不确定",后续可通过与作者核实具体反馈情况,进一步确认反馈机制是否合适。总体来看,有5个条目因信息缺失被评为"不确定",其中受控反馈暂不确定。因此,综合判定本研究整体质量为"低"。 | ||
| DCAT框架 | 中医证候诊断领域(n=50) | 中国临床医学教育领域(n=35) |
|---|---|---|
| 匿名性 | 仅18.0%(9/50)的研究报告了匿名性实施情况,82.0%的研究未呈现匿名性相关内容 | |
| 迭代 | 74.0%(37/50)采用2轮调查,14.0%(7/50)采用3轮,10.0%(5/50)仅1轮,2.0%(1/50)采用5轮;仅26.0%(13/50)预先确定了调查轮次数 | 62.9%(22/35)采用2轮调查,25.7%(9/35)采用3轮,8.6%(3/35)仅1轮,2.9%(1/35)采用4轮;74.3%(26/35)预先确定了调查轮次数 |
| 统计总结 | 98.0%(49/50)的研究清晰论证并报告了数据分析结果;仅26.0%(13/50)预先定义了共识标准 | 97.1%(34/35)的研究对专家意见强度进行了分级;多数研究开展了意见集中程度、协调程度分析;仅2.9%(1/35)预先定义了达成共识的量化标准 |
| 受控反馈 | 30.0%(15/50)的研究描述了轮次间的受控反馈情况 | 77.1%(27/35)的研究未开展任何形式的反馈,8.6%(3/35)开展定性反馈,8.6%(3/35)开展定量反馈,5.7%(2/35)未说明是否反馈 |
| 小组成员专业能力 | 24.0%(12/50)的研究纳入了多学科小组成员;68.0%(34/50)的研究小组仅由临床医师单一群体构成,未覆盖方法学、诊断学等其他领域小组成员;6.0%(3/50)的研究在研究开始前明确了小组成员的筛选标准;32.0%(16/50)提供了专家背景信息 | 100.0%(35/35)的研究在选择专家前进行了背景调查;40.0%(14/35)的研究未定义指标筛选标准;仅45.7%(16/35)提供了专家年龄资料,48.6%(17/35)未提供专家从业年限资料 |
| 利益冲突与伦理 | 仅2.0%(1/50)的研究披露了专家利益冲突相关内容 | 100.0%(35/35)的研究未说明专家知情同意情况 |
Table 11 DCAT framework-based analysis of current Chinese research on the Delphi method
| DCAT框架 | 中医证候诊断领域(n=50) | 中国临床医学教育领域(n=35) |
|---|---|---|
| 匿名性 | 仅18.0%(9/50)的研究报告了匿名性实施情况,82.0%的研究未呈现匿名性相关内容 | |
| 迭代 | 74.0%(37/50)采用2轮调查,14.0%(7/50)采用3轮,10.0%(5/50)仅1轮,2.0%(1/50)采用5轮;仅26.0%(13/50)预先确定了调查轮次数 | 62.9%(22/35)采用2轮调查,25.7%(9/35)采用3轮,8.6%(3/35)仅1轮,2.9%(1/35)采用4轮;74.3%(26/35)预先确定了调查轮次数 |
| 统计总结 | 98.0%(49/50)的研究清晰论证并报告了数据分析结果;仅26.0%(13/50)预先定义了共识标准 | 97.1%(34/35)的研究对专家意见强度进行了分级;多数研究开展了意见集中程度、协调程度分析;仅2.9%(1/35)预先定义了达成共识的量化标准 |
| 受控反馈 | 30.0%(15/50)的研究描述了轮次间的受控反馈情况 | 77.1%(27/35)的研究未开展任何形式的反馈,8.6%(3/35)开展定性反馈,8.6%(3/35)开展定量反馈,5.7%(2/35)未说明是否反馈 |
| 小组成员专业能力 | 24.0%(12/50)的研究纳入了多学科小组成员;68.0%(34/50)的研究小组仅由临床医师单一群体构成,未覆盖方法学、诊断学等其他领域小组成员;6.0%(3/50)的研究在研究开始前明确了小组成员的筛选标准;32.0%(16/50)提供了专家背景信息 | 100.0%(35/35)的研究在选择专家前进行了背景调查;40.0%(14/35)的研究未定义指标筛选标准;仅45.7%(16/35)提供了专家年龄资料,48.6%(17/35)未提供专家从业年限资料 |
| 利益冲突与伦理 | 仅2.0%(1/50)的研究披露了专家利益冲突相关内容 | 100.0%(35/35)的研究未说明专家知情同意情况 |
| [1] |
|
| [2] |
|
| [3] |
|
| [4] |
|
| [5] |
|
| [6] |
|
| [7] |
|
| [8] |
|
| [9] |
|
| [10] |
|
| [11] |
|
| [12] |
|
| [13] |
|
| [14] |
|
| [15] |
|
| [16] |
|
| [17] |
|
| [18] |
|
| [19] |
|
| [20] |
|
| [21] |
|
| [22] |
|
| [23] |
|
| [24] |
井天月,崔梁瑜,李玉坤, 等. 基于德尔菲法的高血压病痰瘀互结证诊断条目专家共识[J]. 中华中医药学刊, 2026, 44(1): 253-258. DOI: 10.13193/j.issn.1673-7717.2026.01.048.
|
| [25] |
|
| [26] |
|
| [27] |
李姝,马青变,谷士贤. 德尔菲法在中国临床医学教育中应用的系统评价[J]. 中华医学教育杂志, 2019, 39(12): 970-973. DOI: 10.3760/cma.j.issn.1673-677X.2019.12.019.
|
| [1] | LI Xiaoyun, DAI Meifen, CAI Shu. Construction of Grading Management Index System for Gestational Hyperglycemia Patients Based on Triangle Hierarchical Management Model [J]. Chinese General Practice, 2026, 29(29): 4303-4309. |
| [2] | DONG Yongfei, CHEN Zhaoyan, SUN Peiyuan, HUANG Huang, HU Zhuolun, LIU Zhencen, CHEN Haichang, LI Xuechao, TIAN Yunhe, LI Zijun, LIU Yadan, LEI Xinyi, ZHANG Wei, YAN Tianming, ZHOU Congjun, WU Fengyi, LILI Shiluo, ZHANG Guanqun, YAN Qi, WU Mengyao, FU Ruiying, LIN Yubing, MA Xiuqi, ZHU Cairong, ZHANG Yawei. Development and Validation of a Core Knowledge Questionnaire for Primary Cancer Prevention: a Delphi and Web-based Respondent-driven Sampling Study [J]. Chinese General Practice, 2026, 29(28): 4147-4156. |
| [3] | XU Kun, CHENG Jingwei, WANG Congshuai, WANG Yinhao, HU Junpeng, LI Wanyue, LIU Yangqing, XI Yan. The Role of Exercise in the Management of Metabolic-associated Fatty Liver Disease: Interpretation of the International Expert Consensus of ACSM and ESSA [J]. Chinese General Practice, 2026, 29(23): 3253-3260. |
| [4] | LIU Hongya, GUO Aizhen, JIN Hua, FU Qiangqiang, SHI Jianjun, ZHANG Hanzhi, YANG Sen, YU Dehua. The Necessity and Training Strategies for Expanding the Responsibilities in General Practice Niche in China: a Study on the Continuous Development of General Practitioners' Sub-specialties Based on the Delphi Method [J]. Chinese General Practice, 2026, 29(20): 2781-2789. |
| [5] | CHEN Cunchuan, ZHANG Huifang, FAN Boyang, SUN Wenning, WANG Yingjie, ZHANG Ao, ZHAO Yang, WANG Haipeng. Construction of Evaluation Indicator System for Primary Care Doctors' Service Capability in Integration of Medical and Preventive Care [J]. Chinese General Practice, 2026, 29(19): 2705-2710. |
| [6] | LIU Xiaoyu, ZHU Rongxin, ZHANG Bo, SU Hang, REN Xianqing. Defining Clinical Questions and Outcome Indicators in Guidelines for Diagnosis and Treatment of Nocturnal Enuresis in Children with Integrated Traditional Chinese and Western Medicine Based on Modified Delphi Method [J]. Chinese General Practice, 2026, 29(15): 2050-2055. |
| [7] | SHEN Yong, ZHOU Jingying, WANG Xueping, JIA Meixiang, LIU Jiajia, ZHAN Haojian, WANG Lifang, YAN Hao, PENG Danyuan, YUE Weihua. Construction of Support Services List for Parents of Children with Autism Based on "Timing It Right" Theory [J]. Chinese General Practice, 2026, 29(13): 1688-1698. |
| [8] | LIU Haiyan, WANG Haitang, DU Zhaohui. The Evaluation Indicators for the High-quality Development of Family Doctor Contract Services Using the Delphi Method [J]. Chinese General Practice, 2026, 29(10): 1277-1285. |
| [9] | PANG Ting, LI Wanxin, ZHANG Haoran, LIN Zhiying, XU Xin. Construction of the Evaluation System of Cognitive Impairment Screening Service in the Community Based on RE-AIM Framework [J]. Chinese General Practice, 2026, 29(08): 1044-1050. |
| [10] | HUANG Zichen, XIA Zhongyuan, ZHI Congcong, CHEN Ying, LIU Ningyuan, LIU Dianlong, ZHENG Lihua. Defining Clinical Queries and Construction of Outcome Indexes in Guidelines on the Diagnosis and Treatment of Anal Fistula by Integrated Traditional Chinese and Western Medicine [J]. Chinese General Practice, 2025, 28(32): 4095-4101. |
| [11] | ZHI Congcong, CHENG Yicheng, HUANG Zichen, WANG Xiaolong, LI Xue, ZHENG Lihua. Collection and Determination of Clinical Questions and Outcome Indicators Based on the Guidelines for Integrated Traditional Chinese and Western Medicine Diagnosis and Treatment of Hemorrhoids (2025 Edition) [J]. Chinese General Practice, 2025, 28(32): 4089-4094. |
| [12] | ZHENG Caiyun, WU Shuanger, YU Ganquan, WANG Xin. Construction of Evaluation Index System Inter-professional Collaboration in Family Doctor Team [J]. Chinese General Practice, 2025, 28(28): 3518-3524. |
| [13] | ZHAO Wenwen, LI Nuoya, ZHANG Yali, ZHANG Jinjia, ZHANG Min, LIU Hualei, XI Biao, WANG Rongying. Research on Evaluation of Quality Evaluation System of General Practice Faculty in Standardized Clinical Residency Training Bases (General Hospitals) [J]. Chinese General Practice, 2025, 28(25): 3187-3192. |
| [14] | WEI Xu, YIN Yuhui, WANG Xu, YU Ruowen, ZHANG Yili, SUN Kai, WANG Hui, XIE Shiming, LI Yan, QIN Xiaokuan, YIN Xunlu, LI Linghui, ZHU Liguo. Study on the Assessment System of Bone Health Service Capacity of Primary Healthcare Institutions [J]. Chinese General Practice, 2025, 28(19): 2354-2362. |
| [15] | CHEN Yi, BAI Wenpei, LI Hongtian, WANG Yao, TIAN Zongmei, GU Bei, LIU Xiaohong, YANG Mukun. Construction of a Comprehensive Health Management Evaluation Indicator System for Menopausal Women [J]. Chinese General Practice, 2025, 28(14): 1781-1787. |
| Viewed | ||||||
|
Full text |
|
|||||
|
Abstract |
|
|||||
